Ⅰ. 가중치 스트리밍 로딩 기술이란?
트래픽 스파이크로 인해 파드(Pod)가 스케일아웃되었으나 모델 기동에 5분이 걸려 이미 트래픽이 끝났거나, 스팟 GPU 노드를 섞어 썼더니 회수 시 대체 파드가 뜨는 시간 동안 가용성에 구멍이 뚫리는 경험은 LLM 서빙의 흔한 장벽입니다. 가중치를 이미지에 구워 넣으면 레지스트리 병목이 생깁니다. 이 문제들의 뿌리는 "모델 가중치를 로컬 디스크로 전부 다운로드한 뒤, 텐서를 순서대로 하나씩 GPU로 올리는 동기(Sync) 방식의 기본 로더"에 있습니다.
가중치 스트리밍 로딩(Weight Streaming Loading)은 이 전제를 깹니다. safetensors 파일의 헤더(오프셋)를 미리 해석해 파일을 수십 개의 청크로 쪼개고, 다수의 스레드가 동시에 읽어 CPU 버퍼에 채우면서, 준비된 텐서부터 즉시 GPU로 올리는 로딩 방식입니다. 즉, "읽기"와 "전송"이 동시에 겹쳐서 돌아가기 때문에 전체 로딩 시간이 두 단계의 합이 아닌 "둘 중 더 느린 쪽의 시간" 으로 수렴하게 됩니다. (대표 구현체: NVIDIA Run:ai Model Streamer)
Ⅱ. 가중치 스트리밍 로딩 기술 특징
이 기술은 무언가를 해결하기 위해 다른 자원(CPU, 메모리)을 대가로 지불하는 형태를 띱니다.
| 주요 특징 | 장점 | 단점/주의 |
| 다중 스레드 병렬 읽기 | 큐 깊이 1의 동기 읽기를 없애 저장소 대역폭을 100% 활용합니다. | 읽기 스레드가 실제 CPU 코어를 다수 소비합니다. |
| 읽기와 H2D 전송 중첩 | 전체 소요 시간이 각 단계의 단순 합산이 아니라, 병렬로 겹쳐서 비약적으로 단축됩니다. | PCIe 대역폭이 병목이면 처리량이 나아지지 않습니다. |
| 오브젝트 스토리지 직접 읽기 | 로컬 디스크 다운로드 단계를 제거하고, 로컬 디스크 요구 용량을 없앱니다. | 파드가 재시작될 때마다 S3에서 다시 읽으므로 네트워크 비용이 발생합니다. |
| CPU 버퍼 상한 설정 | 파일 크기와 무관하게 호스트 메모리 사용량을 통제합니다. | 설정값(기본 40GB)이 컨테이너 Limit을 넘으면 OOMKilled가 발생합니다. |
| 포맷 변환 불필요 | 배포 중인 safetensors를 변환 없이 그대로 쓸 수 있습니다. | 반대로 safetensors가 아니면(GGUF, bin 등) 아예 켤 수 없습니다. |
Ⅲ. 가중치 스트리밍 로딩 기술 동작방식
스트리밍 파이프라인은 5가지 핵심 구성 요소가 각자의 자원을 릴레이처럼 넘겨받으며 동작합니다.
ⅰ. safetensors 헤더 파싱: 파일 앞부분의 JSON 헤더만 먼저 읽어 모든 텐서의 바이트 범위를 알아냅니다. (이 성질이 기술의 전제조건입니다)
ⅱ. 스트리머 코어 (C++): 스레드 풀(Thread Pool)이 오프셋 지도를 바탕으로 청크(보통 로컬 2MB, S3 8MB) 단위의 병렬 읽기(pread 또는 Range GET)를 발행합니다.
ⅲ. CPU 스테이징 버퍼: 읽어 들인 바이트가 잠시 머무는 고정 크기 링 버퍼입니다. 가득 차면 읽기 스레드가 대기합니다.
ⅳ. 텐서 이터레이터: 청크가 모두 모여 완성된 텐서를 파이썬(vLLM) 로더에 순서대로 넘깁니다.
ⅴ. H2D 전송 및 버퍼 반납: vLLM이 텐서를 GPU 메모리(to("cuda"))로 전송합니다. 전송이 끝나면 버퍼 슬롯은 다음 청크를 위해 즉시 반납됩니다.
Ⅳ. 가중치 스트리밍 로딩 구성 및 흐름도
기존 순차 로딩과 스트리밍 로딩이 "시간축에서 어떻게 겹쳐 도는지(Overlap)"를 직관적으로 보여주는 다이어그램입니다.
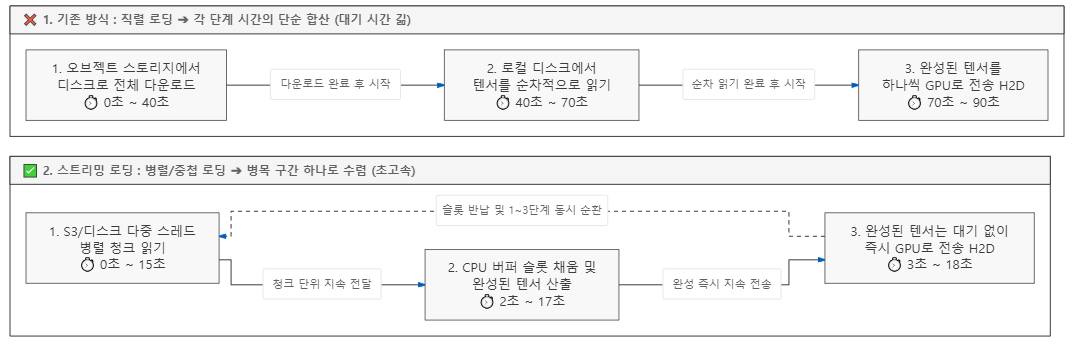
[병목 판별 핵심 규칙] concurrency(동시성) 값을 올렸을 때 처리량이 함께 늘어나면 아직 저장소에 여유가 있는 것입니다. 처리량은 그대로인데 CPU 사용률만 오르면 저장소 대역폭의 상한에 달한 것이며, CPU/저장소 모두 여유가 있다면 PCIe 버스 한계이거나 단일 대형 텐서에 갇힌 것입니다.
Ⅴ. 가중치 스트리밍 기술 설치 방법
모델 포맷이 .safetensors인지, 서버의 코어 수(nproc)가 충분한지 확인한 후 vLLM 환경에 라이브러리를 설치합니다. (vLLM 0.30.0 이상 권장)
bash
# ⅰ. vLLM 추가 의존성으로 한 번에 설치
pip3 install 'vllm[runai]'

# ⅱ. 저장소 백엔드 개별 설치 (이미지 경량화 목적)
pip3 install runai-model-streamer runai-model-streamer-s3

# ⅲ. 설치 직후 동작 검증 (플래그 적용 여부 확인)
vllm serve /models/Llama-3.1-8B-Instruct \
--load-format runai_streamer \
--model-loader-extra-config '{"concurrency":16}' 2>&1 | tee /tmp/boot.log

# 로그에서 'load_format=LoadFormat.RUNAI_STREAMER'가 보이면 정상,
# 'SAFETENSORS'나 'AUTO'로 찍혀있다면 호환성 문제로 조용히 폴백된 것입니다.
Ⅵ. 가중치 스트리밍 기술 사용 방법 및 K8s 최적화
실제 운영 클러스터(Kubernetes)에 적용할 때 가장 중요한 매니페스트 필수 설정 4가지입니다.
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
name: llama-8b
spec:
template:
spec:
containers:
- name: vllm
args:
- --model=s3://models/Llama-3.1-8B-Instruct
- --load-format=runai_streamer
- --model-loader-extra-config={"concurrency":16,"memory_limit":17179869184}
env:
- name: VLLM_CACHE_ROOT # ① 컴파일 캐시를 영속 볼륨으로 지정 (필수)
value: /cache/vllm
resources:
limits:
nvidia.com/gpu: "1"
memory: 48Gi # ② memory_limit 설정값의 2배 이상으로 충분히 할당
cpu: "16" # ③ concurrency(16)를 받쳐줄 CPU 코어 상한 확보
startupProbe: # ④ 로딩 중 재시작 루프 방지 (최악 로딩 시간의 2배 임계치 설정)
httpGet: { path: /health, port: 8000 }
periodSeconds: 10
failureThreshold: 60
volumeMounts:
- { name: compile-cache, mountPath: /cache }- 사내 MinIO/Ceph RGW 연동 주의사항: S3가 아닌 사내망 스토리지 연결 시 환경변수에 RUNAI_STREAMER_S3_USE_VIRTUAL_ADDRESSING=0 및 AWS_EC2_METADATA_DISABLED=true를 반드시 추가해야 기동 지연 및 403 오류를 막을 수 있습니다.
Ⅶ. 자주 쓰는 명령어 및 분석 도구
구간별 소요 시간을 뽑아내어 병목을 찾는 것이 튜닝의 출발점입니다.
| 분석 명령어 / 도구 | 용도 및 판단 기준 |
| grep -iE 'Loading weights took|torch.compile' 로그 | 튜닝의 기준점. 가중치 로딩 시간과 커널 컴파일 소요 시간 추출 |
| iostat -x 1 nvme0n1 | 로컬 로딩 시 디스크가 상한(%util 100)인지 파악 |
| sar -n DEV 1 | S3 로딩 시 네트워크(NIC) 트래픽 상한 도달 여부 점검 |
| nvidia-smi dmon -s pucm | 로딩 중 GPU 메모리가 계단식으로 멈춰서 증가한다면 읽기 속도가 밀리는 중임 |
| cat /sys/fs/cgroup/memory.max | 컨테이너 찐 메모리 한계. memory_limit 설정과 비교하여 OOM 예측 |
| s5cmd --numworkers 32 cp s3://... /dev/null | 로더와 무관한 S3 순수 다운로드 대역폭 상한 측정 (목표 기준선) |
- 💡 [Secret Tip] safetensors 헤더 구조 분석 스크립트 스트리밍을 켰는데 로딩이 개선되지 않는다면, 아래 파이썬 스크립트로 모델 내부 텐서 크기를 점검하세요. 단 1개의 텐서가 4GiB를 차지하는 식의 극단적 레이아웃이라면 병렬화가 무의미해져 꼬리 지연이 발생합니다.
python
import json, struct, glob
for f in sorted(glob.glob("/models/mymodel/*.safetensors")):
with open(f, "rb") as fh:
n = struct.unpack("<Q", fh.read(8))[0]
hdr = json.loads(fh.read(n))
t = [k for k in hdr if k != "__metadata__"]
big = max(hdr[k]["data_offsets"][1] - hdr[k]["data_offsets"][0] for k in t)
print(f.split("/")[-1], "tensors=", len(t), "max_tensor_MiB=", big // 1048576)
Ⅷ. 스트리밍 로딩 활용방안 및 대안 기술
이 기술이 가장 빛을 발하는 곳과 도입하면 안 되는 곳의 명확한 기준입니다.
✅ 적극 도입 권장 (효과 극대화)
- ⅰ. 수요 기반 오토스케일링: 트래픽 폭주 시 파드 기동이 1분 이내여야 HPA가 실제로 방어막 역할을 합니다.
- ⅱ. 스팟/선점형 GPU 노드 풀: 노드 회수 통지 2~3분 내에 대체 파드를 띄워 가용성을 지켜냅니다.
- ⅲ. 모델 버전 빈번 릴리스: 70GB 모델을 이미지에 구우면 배포마다 레지스트리가 폭발하지만, S3 경로만 바꾸면 즉시 롤아웃/롤백이 가능해집니다.
- ⅳ. 콜드스타트 지분율이 이미지 Pull > 가중치 로딩 인 곳: 28GB 이미지를 당겨오는 데 200초가 걸린다면 로딩을 0초로 만들어봤자 체감이 없습니다. 노드 이미지 캐시부터 해결해야 합니다.
❌ 도입 금지 (효과 없음)
- ⅴ. 수 주에 한 번 재시작하는 단일 파드: 한 번 띄워놓고 오래 쓰는 서버는 복잡도 대비 이득이 전혀 없습니다.
- ⅵ. 이미 네트워크/디스크 대역폭이 상한인 곳: 저장소 스펙이 병목이라면 스레드만 늘린다고 해결되지 않습니다.
Ⅸ. 운영 중 자주 겪는 트러블 슈팅
| 주요 증상 | 원인 및 해결 조치 방법 |
| 1. Concurrency를 올려도 전혀 안 빨라짐 | 저장소 대역폭의 한계치에 도달함. 무의미하게 concurrency만 계속 바꾸며 시간 낭비하지 말고, 상위 볼륨 등급으로 올리거나 저장소를 교체해야 함. |
| 2. 파드가 기동 중 OOMKilled 발생 | memory_limit 기본값이 40GB이므로, 컨테이너 제한이 32GB인 환경에서는 무조건 죽음. memory_limit을 컨테이너 Limit의 절반 수준(예: 16GB)으로 명시할 것. |
| 3. 사내 MinIO 접속 시 타임아웃 / 지연 | AWS_EC2_METADATA_DISABLED=true 누락. AWS 외부 환경에서 메타데이터를 찾느라 수십 초 타임아웃을 대기하므로 필수 환경변수 적용. |
| 4. 파드 1개는 10초, 스케일아웃 시 40초 지연 | 파드 10개가 동시 기동하며 S3에 10배의 요청을 때려 스토리지 API 제한에 걸린 상황. 동시 기동 수를 통제하고, 다수 노드 배포 시의 속도를 진짜 SLO로 삼아야 함. |
| 5. 가중치 로딩은 줄었는데 기동 시간은 그대로 | torch.compile 해놓은 커널 코드가 영구 보존되지 않고 재기동마다 다시 컴파일 중. VLLM_CACHE_ROOT를 영속 볼륨(PVC)으로 빼내어 파드 간 재사용할 것. |
| 6. 기동 중 프로세스가 자꾸 재시작함 | startupProbe 없이 livenessProbe만 있어 헬스체크 실패로 무한 킬 루프에 빠짐. startupProbe의 임계치를 넉넉히 둘 것. |
| 7. 모델 교체 후 성능이 조용히 나빠짐 | 새 모델이 safetensors가 아니어서 기본 로더로 조용히 **폴백(Fallback)**된 상황. 배포 스크립트에 Loading weights took 로그 추출 로직을 넣어 성능 회귀를 반드시 탐지해야 함. |
'AI(Artificial Intelligence)' 카테고리의 다른 글
| 딥러닝 표준 PyTorch 아키텍처, 텐서 연산, 설치 방법 및 활용 (0) | 2026.09.17 |
|---|---|
| 기업의 새로운 위협, Shadow AI 현상과 강력한 통제 기술 (0) | 2026.08.26 |
| 완벽하게 통제되는 나만의 로컬 LLM 게이트웨이(Openclaw) 구축 (0) | 2026.08.19 |
| 헤르메스(Hermes) 에이전트 (나만의 24시간 AI 자동화 비서 구축) (0) | 2026.08.18 |
| 양자머신러닝(QML)이란? 핵심 개념부터 하이브리드 아키텍처 구조 (0) | 2026.07.22 |