딥러닝 모델을 만들려면 행렬 계산을 GPU에서 빠르게 돌리고, 학습에 필요한 미분 값을 자동으로 구해 줄 도구가 필요합니다. 초창기 프레임워크는 계산 그래프를 먼저 통째로 정의한 뒤 실행하는 방식(정적 그래프)을 썼는데, 이 방식은 중간 값을 들여다보기 어려워 디버깅이 까다로웠습니다. PyTorch는 코드를 한 줄씩 실행하며 그때그때 그래프를 만드는 방식(동적 그래프)을 택해, 평소 파이썬을 쓰듯 모델을 짜고 print나 디버거로 중간 값을 바로 확인할 수 있게 했습니다. 이 편한 사용감 덕분에 연구와 실무 양쪽에서 표준처럼 자리 잡았습니다.
Ⅰ. PyTorch (파이토치) 란?
메타(구 페이스북) AI 연구소에서 개발하고 현재 리눅스 재단(PyTorch Foundation)이 관리하는 파이썬 기반의 오픈소스 딥러닝 프레임워크입니다. 초창기 프레임워크들이 채택했던 계산 그래프를 먼저 통째로 정의한 뒤 실행하는 방식(정적 그래프)의 단점을 극복하고, 코드를 한 줄씩 실행하며 그때그때 그래프를 만드는 동적 계산 그래프(Define-by-Run) 방식을 채택했습니다. 평소 파이썬 코드를 짜듯 직관적으로 모델을 구성하고 print문 등으로 중간 값을 바로 확인할 수 있어 딥러닝 연구와 실무의 표준으로 자리 잡았습니다.
Ⅱ. PyTorch (파이토치) 특징
ⅰ. 동적 계산 그래프: 실행 시점에 그래프가 만들어지므로, 입력에 따라 흐름이 달라지는 조건문이나 반복문이 포함된 모델도 자연스럽게 표현하고 쉽게 디버깅할 수 있습니다.
ⅱ. 텐서와 GPU 가속: NumPy와 유사한 다차원 배열인 '텐서(Tensor)'를 사용하며, .to("cuda") 한 줄만으로 엔비디아 CUDA뿐 아니라 AMD ROCm, 애플 실리콘(MPS) 등에서 GPU 가속 연산이 가능합니다.
ⅲ. 자동 미분 (Autograd): 순전파(Forward) 과정을 자동으로 기록해 두었다가, .backward() 함수 한 번 호출로 딥러닝 학습에 필수적인 그래디언트(기울기)를 자동으로 계산합니다.
ⅳ. 모듈식 구조 설계: nn.Module로 신경망 계층을 블록처럼 조립하고, torch.optim(최적화 기법), DataLoader(데이터 공급)를 조합하여 구조적이고 재사용성 높은 학습 루프를 짤 수 있습니다.
ⅴ. 거대한 생태계 및 가속 기능: 공식 확장(torchvision, torchaudio), HuggingFace(Transformers), PyTorch Lightning 등 방대한 생태계를 갖추었으며, 최신 2.x 버전부터는 torch.compile을 통한 JIT 컴파일 가속을 지원합니다.
Ⅲ. PyTorch (파이토치) 특징
학습 과정은 다음 5가지 핵심 구성 요소의 상호작용으로 이루어집니다.
ⅰ. 텐서(Tensor): 연산 기록 기능(requires_grad)을 갖춘 데이터 및 파라미터 컨테이너
ⅱ. 모델(nn.Module): 입력을 받아 예측을 내놓는 순전파(forward) 과정을 정의하는 신경망 본체
ⅲ. 손실 함수(Loss): 예측값과 실제 정답 간의 차이(오차)를 하나의 수치로 계산
ⅳ. autograd 엔진: 오차를 거꾸로 추적하며 각 파라미터가 오차에 미친 영향(그래디언트)을 계산
ⅴ. 옵티마이저(Optimizer): 계산된 그래디언트를 바탕으로 파라미터를 갱신(학습)
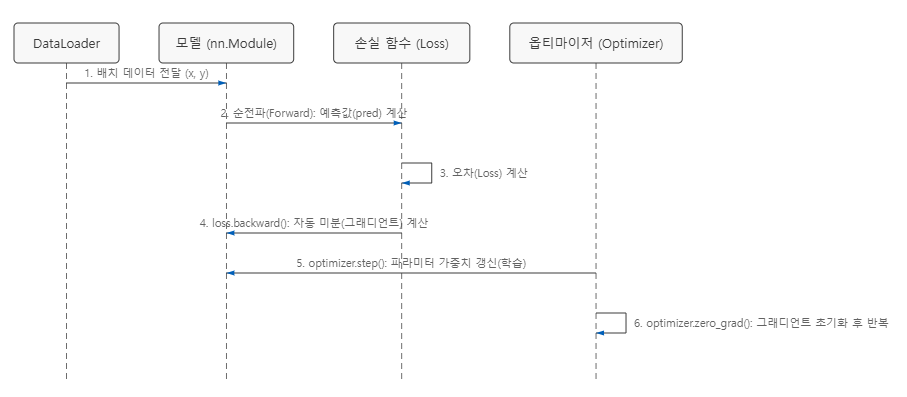
Ⅳ. PyTorch (파이토치) 구성 및 흐름도
(대부분의 PyTorch 학습 코드에 공통으로 들어가는 5단계 표준 흐름입니다.)
Ⅴ. PyTorch (파이토치) 설치 방법
Python 3.10 이상의 환경에서 pip를 통해 설치합니다. 시스템의 CUDA 버전에 맞는 빌드를 선택하는 것이 가장 중요하며, 공식 사이트(pytorch.org)에서 정확한 명령어를 확인하는 것을 권장합니다.
# 1. CPU 전용 설치
pip install torch torchvision torchaudio
# 2. GPU 지원 설치 (예: CUDA 12.1 환경)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
# 3. 설치 및 GPU 인식 여부 확인 (True가 나와야 정상)
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"
Ⅵ. PyTorch (파이토치) 사용 방법
모델과 데이터를 같은 장치(Device)에 올리고, 매 반복마다 그래디언트를 비워주는 뼈대 코드입니다.
import torch
import torch.nn as nn
# 1. 디바이스 설정 및 모델, 손실함수, 옵티마이저 선언
device = "cuda" if torch.cuda.is_available() else "cpu"
model = nn.Linear(10, 1).to(device)
loss_fn = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
# 2. 모델 학습 모드 전환
model.train()
# 3. 학습 루프
for x, y in dataloader:
    x, y = x.to(device), y.to(device) # 장치 일치시키기

    pred = model(x)              # ① 순전파 (예측)
    loss = loss_fn(pred, y)      # ② 손실 계산

    optimizer.zero_grad()        # ③ 그래디언트 초기화 (매우 중요)
    loss.backward()              # ④ 역전파 (자동 미분)
    optimizer.step()             # ⑤ 파라미터 갱신
Ⅶ. PyTorch (파이토치) 자주 쓰는 명령어
| 코드 | 설명 |
| torch.tensor(data) | 리스트나 배열 데이터로부터 텐서 생성 |
| x.to(device) | 텐서나 모델을 지정한 장치(CPU/GPU)로 이동 |
| loss.backward() | 오차에 대한 파라미터의 그래디언트를 역전파로 자동 계산 |
| optimizer.zero_grad() | 이전 스텝의 그래디언트가 누적되지 않도록 0으로 초기화 그래디언트 초기화 / 파라미터 갱신 |
| optimizer.step() | 계산된 그래디언트를 바탕으로 모델의 파라미터 갱신 |
| model.train() / model.eval() | 모델을 학습(Train) 모드 / 추론(Eval) 모드로 전환 (Dropout, BatchNorm 동작 제어) |
| with torch.no_grad(): | 추론 시 불필요한 그래디언트 기록을 비활성화하여 메모리와 연산량 절약 |
| torch.save() / torch.load() | 모델 가중치(Weights) 파일(.pt, .pth) 저장 및 불러오기 |
| torch.compile(model) | 모델을 JIT 컴파일하여 실행 속도 향상 (PyTorch 2.0 이상 지원) |
Ⅷ. PyTorch (파이토치) 활용 방안
✅ 이렇게 활용하세요 (Best Practice)
ⅰ. 새로운 모델 구조 연구 및 실험: 디버깅이 편해 논문을 구현하거나 새로운 아이디어를 테스트하는 R&D 단계에 최적화되어 있습니다.
ⅱ. 공개 모델 미세 조정(Fine-Tuning): HuggingFace 생태계와의 완벽한 궁합으로, 트랜스포머 기반의 LLM이나 최신 공개 모델을 가져와 커스텀 학습하기 좋습니다.
ⅲ. 대규모 분산 학습: DDP, FSDP 등을 통해 여러 개의 GPU와 노드에서 대규모 파라미터를 효율적으로 분산 학습시킬 때 활용합니다.
❌ 이런 목적으론 대안을 고려하세요
ⅰ. 모바일 및 브라우저 엣지(Edge) 배포: 파이썬 런타임이 무거울 수 있습니다. PyTorch 모델을 ONNX로 내보내 전용 엔진에서 돌리거나, 모바일 배포 환경이 잘 구축된 TensorFlow(TFLite)를 고려할 수 있습니다.
ⅱ. 초대규모 병렬 연구 최적화: 함수형 패러다임과 컴파일 최적화가 필수인 일부 특수 연구에서는 JAX가 유리할 수 있습니다.
Ⅸ. PyTorch (파이토치) 트러블 슈팅
ⅰ. CUDA out of memory: GPU 메모리가 부족하다는 오류입니다. 배치 크기를 줄이거나, 혼합 정밀도(torch.cuda.amp)로 메모리를 아끼거나, 작은 배치를 여러 번 모아 갱신하는 그래디언트 누적을 씁니다. 추론에서는 no_grad를 잊지 않았는지도 확인합니다.
ⅱ. 손실이 줄지 않을 때: optimizer.zero_grad()를 빼먹으면 그래디언트가 계속 누적되어 학습이 엉킵니다. 매 스텝 초기화하는지, 학습률이 지나치게 크거나 작지 않은지 먼저 점검합니다.
ⅲ. 장치 불일치 오류: "Expected all tensors to be on the same device" 류의 오류는 모델과 입력이 서로 다른 장치에 있을 때 납니다. 데이터와 모델 모두 같은 device로 옮겼는지 확인합니다.
ⅳ. GPU를 못 잡을 때: torch.cuda.is_available()이 False라면 설치한 torch 빌드의 CUDA 버전과 시스템 드라이버가 맞지 않는 경우가 대부분입니다. index-url의 cuXXX를 맞춰 다시 설치합니다.
'AI(Artificial Intelligence)' 카테고리의 다른 글
| 기업의 새로운 위협, Shadow AI 현상과 강력한 통제 기술 (0) | 2026.08.26 |
|---|---|
| 완벽하게 통제되는 나만의 로컬 LLM 게이트웨이(Openclaw) 구축 (0) | 2026.08.19 |
| 헤르메스(Hermes) 에이전트 (나만의 24시간 AI 자동화 비서 구축) (0) | 2026.08.18 |
| 양자머신러닝(QML)이란? 핵심 개념부터 하이브리드 아키텍처 구조 (0) | 2026.07.22 |
| "에이전트는 1명일 필요가 없다" : CrewAI의 본질과 멀티에이전트의 딜레마 (1) | 2026.07.14 |