DPDK(Data Plane Development Kit)는 리눅스 커널 네트워크 스택을 통째로 우회하고, 유저스페이스 프로세스가 NIC를 직접 제어하도록 만드는 라이브러리·드라이버 모음입니다. 방화벽·로드밸런서·5G UPF·가상 스위치처럼 초당 수천만 패킷을 다뤄야 하는 소프트웨어가 범용 서버에서 돌아갈 수 있게 된 것은 거의 전적으로 이 계층 덕분입니다. 2026년 현재 최신 릴리스는 26.07이고, 프로덕션 기준선은 3년 지원의 25.11 LTS입니다. 이 글은 DPDK를 "빠른 네트워크 라이브러리"가 아니라 CPU 코어와 운영 가시성을 대역폭·지연으로 맞바꾸는 아키텍처 결정으로 다룹니다. 결론부터 말하면, DPDK를 도입하는 순간 잃는 것이 얻는 것만큼 구체적이며, 그 목록을 모르고 시작한 프로젝트는 대부분 6개월쯤 뒤에 후회합니다.
Ⅰ. DPDK 란?
문제는 산수에서 출발합니다. 10GbE 회선에서 최소 크기(64바이트) 프레임이 가득 찬 상태를 라인레이트라 부르고, 그 값은 초당 14.88M 패킷입니다. 패킷 하나에 허용된 시간은 약 67나노초, 3GHz CPU로 환산하면 200 사이클 남짓입니다. 그런데 이 200 사이클 안에 리눅스 커널이 평소 하는 일을 넣어 보면 답이 나오지 않습니다.
| 커널 스택이 패킷마다 하는 일 | 왜 비싼가 | DPDK가 없앤 방식 |
| 하드웨어 인터럽트 + softirq | 컨텍스트 전환과 캐시 오염. 부하가 높을수록 인터럽트 자체가 부하가 되는 livelock | 폴링(PMD). 인터럽트를 끄고 전용 코어가 디스크립터 링을 계속 돌며 확인 |
| sk_buff 동적 할당·해제 | 패킷당 수백 바이트 구조체를 슬랩에서 할당. 메타데이터가 페이로드보다 큼 | mempool + mbuf. 기동 시 전부 사전 할당해 두고 포인터만 주고받음 |
| 커널↔유저 메모리 복사 | recvmsg() 한 번마다 복사와 시스템 콜 | 제로 카피. NIC가 DMA로 쓴 버퍼를 유저 프로세스가 그대로 읽음 |
| 범용 프로토콜 스택 통과 | netfilter 훅, 라우팅 조회, 소켓 매칭 등 쓰지도 않을 기능의 분기 비용 | 스택 자체가 없음. 필요한 처리만 애플리케이션이 직접 구현 |
| 4KB 페이지 기반 메모리 접근 | 대용량 버퍼 순회 시 TLB 미스가 지속 발생 | Hugepage(2MB/1GB). TLB 엔트리 하나가 훨씬 넓은 영역을 커버 |
| 공유 자료구조의 락 경합 | 코어 수를 늘려도 캐시라인 핑퐁으로 성능이 오히려 꺾임 | 코어별 전용 큐 + lockless ring. RSS로 흐름을 코어에 고정 |
여기서 오해를 하나 정리해야 합니다. 커널 스택이 못 만든 물건이어서 느린 것이 아닙니다. 커널 스택은 수천 개의 서로 다른 애플리케이션, 수십 종의 프로토콜, 임의의 트래픽 패턴을 안전하고 공평하게 처리하도록 설계되었습니다. DPDK는 그 요구사항을 전부 포기하는 대가로 속도를 얻습니다. 즉 DPDK는 커널보다 똑똑한 것이 아니라 훨씬 적은 일을 하도록 허락받은 것이고, 이 문장이 이 글 전체의 요약입니다.
정의하자면 DPDK는 Linux Foundation 산하의 오픈소스 프로젝트로, EAL(환경 추상화 계층), 메모리·큐 자료구조, 벤더별 폴링 모드 드라이버(PMD), 그리고 해시·LPM·암호·압축 같은 보조 라이브러리의 집합입니다. 릴리스는 연 3~4회이고 매년 11월 릴리스(X.11)가 LTS로 지정되어 3년간 유지보수됩니다. 프로덕션이라면 개발 브랜치가 아니라 LTS를 고르는 것이 사실상 유일한 선택지입니다.
Ⅱ. DPDK 주요 특징
| 특징 | 내용 | 치르는 대가 |
| 폴링 모드 드라이버(PMD) | 인터럽트 없이 RX 디스크립터 링을 rte_eth_rx_burst()로 계속 조회 | 트래픽이 0이어도 CPU 사용률 100%. 코어가 통째로 묶임 |
| 버스트 처리 | 패킷을 32개 단위로 묶어 처리해 명령어 캐시와 분기 예측을 살림 | 저부하에서 지연이 오히려 늘 수 있음(버스트가 찰 때까지 대기하도록 짜면) |
| 사전 할당 mempool·mbuf | 런타임 할당 0. 코어별 캐시를 둬 경합 없이 꺼내 씀 | 메모리를 기동 시 전부 선점. 다른 프로세스와 나눠 쓰기 어려움 |
| Hugepage 기반 메모리 | 2MB·1GB 페이지로 TLB 미스를 구조적으로 줄임 | 부팅 파라미터·NUMA별 할당 등 호스트 사전 설정이 필수 |
| NUMA 인지 설계 | NIC가 물린 소켓의 로컬 메모리·로컬 코어를 골라 씀 | 배치를 틀리면 성능이 절반 이하로 조용히 떨어짐 |
| lockless ring | CAS 기반 단일/다중 생산자-소비자 큐로 코어 간 전달 | 파이프라인 설계를 개발자가 직접 해야 함 |
| RSS / rte_flow | 하드웨어가 흐름 해시로 큐를 분배. rte_flow로 벤더 중립 오프로드 규칙 기술 | 지원 범위가 NIC마다 다름. "되는 줄 알았는데 이 카드에선 안 되는" 일이 흔함 |
| vhost-user / virtio-user | VM·컨테이너와 공유 메모리로 직결. OVS-DPDK의 근간 | 공유 메모리 모델이라 격리 수준이 낮음 |
| AF_XDP PMD | 커널 AF_XDP 소켓을 DPDK 포트처럼 사용. 커널 드라이버를 유지한 채 일부 성능 확보 | 순수 DPDK 대비 처리량은 낮음. 절충안으로 이해해야 함 |
| 멀티 벤더 추상화 | Intel·NVIDIA(Mellanox)·Broadcom·AWS ENA 등 동일 API로 접근 | 추상화는 API까지. 성능 특성과 기능 지원은 벤더마다 제각각 |
Ⅲ. DPDK 동작 방식
ⅰ. 구성 요소. DPDK 애플리케이션은 라이브러리를 "호출하는" 프로그램이 아니라, DPDK가 깔아 놓은 실행 모델 위에서 사는 프로그램입니다. 이 차이가 처음 접할 때 가장 혼란스러운 부분입니다.
| 구성 요소 | 역할 | 실무에서 걸리는 지점 |
| EAL (환경 추상화 계층) | hugepage 확보, PCI 장치 스캔, lcore 스레드 생성·고정, 로그·인자 파싱 | 기동 실패의 9할이 여기. hugepage·IOMMU·권한 문제가 전부 EAL 단계에서 터짐 |
| lcore (논리 코어) | 물리 코어에 1:1로 고정된 스레드. 각자 독립 루프를 돎 | OS 스케줄러와 코어를 두고 싸우면 지터가 폭증. 격리 필요 |
| mempool / mbuf | 패킷 버퍼 풀과 그 안의 개별 패킷 구조체. 헤드룸·체인 지원 | 해제 누락 = 조용한 고갈. 몇 시간 뒤 트래픽이 멎음 |
| PMD | 벤더별 드라이버. 디스크립터 링 조작과 오프로드 설정 담당 | 커널 드라이버와 동시에 물릴 수 없음. 바인딩 전환이 필요 |
| rte_ring | 코어 간 무락 큐. run-to-completion과 파이프라인 모델의 연결부 | 크기를 작게 잡으면 드랍, 크게 잡으면 지연과 캐시 미스 |
| rte_flow | 매칭·액션을 선언해 NIC 하드웨어로 분류·전환을 오프로드 | 규칙이 하드웨어 용량을 넘으면 조용히 소프트웨어 폴백 |
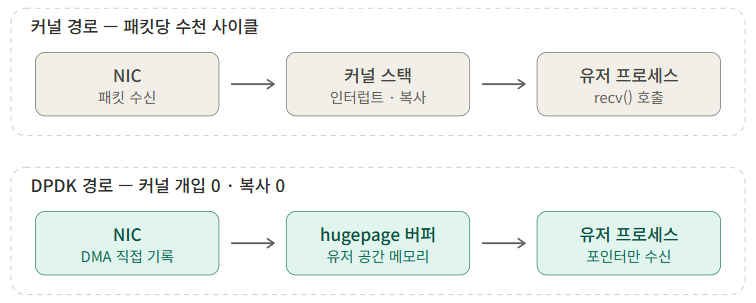
ⅱ. 데이터 흐름. 핵심은 패킷이 복사되지 않는다는 것입니다. NIC가 DMA로 hugepage 영역에 직접 쓰고, 애플리케이션은 그 주소를 담은 mbuf 포인터를 버스트 단위로 받습니다. 처리 후 TX 큐에 포인터를 넣으면 NIC가 같은 메모리에서 직접 읽어 갑니다. 패킷 데이터는 메모리에 한 번 자리 잡은 뒤 끝까지 움직이지 않고, 이동하는 것은 포인터뿐입니다.
ⅲ. 두 가지 실행 모델. 하나는 run-to-completion으로, 한 코어가 수신부터 송신까지 전부 처리합니다. 캐시 지역성이 좋고 구조가 단순해 대부분의 경우 먼저 시도해야 할 모델입니다. 다른 하나는 파이프라인으로, 코어마다 단계를 나누고 rte_ring으로 넘깁니다. 단계별 처리 비용이 크게 다르거나 암호화 같은 무거운 단계가 있을 때 유리하지만, 링을 건널 때마다 캐시가 식고 지연이 쌓입니다. 경험적으로 파이프라인은 "run-to-completion으로 해 봤는데 특정 단계가 병목임이 측정으로 확인된 뒤"에 가는 것이 맞습니다. 처음부터 파이프라인으로 설계했다가 더 느려지는 사례를 드물지 않게 봅니다.
Ⅳ. DPDK 구성 및 동작 흐름도
[그림 1] 커널 경로와 DPDK 경로 — 같은 패킷이 어디를 지나는지가 성능 차이의 전부입니다.
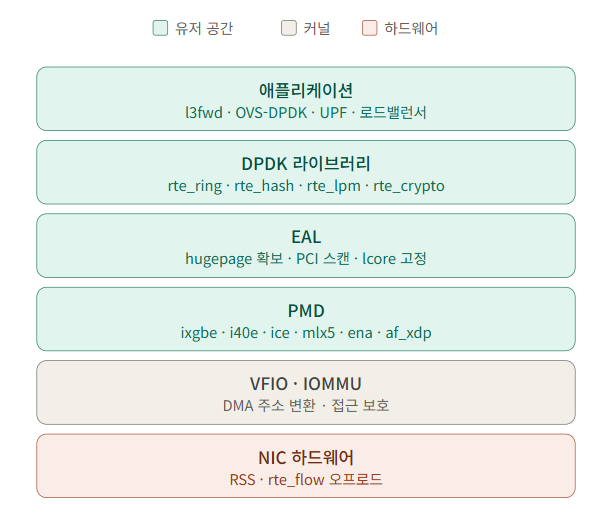
[그림 2] 계층 구조 — 아래로 갈수록 하드웨어에 가까워집니다. 회색 칸이 커널이 허락한 유일한 통로입니다.
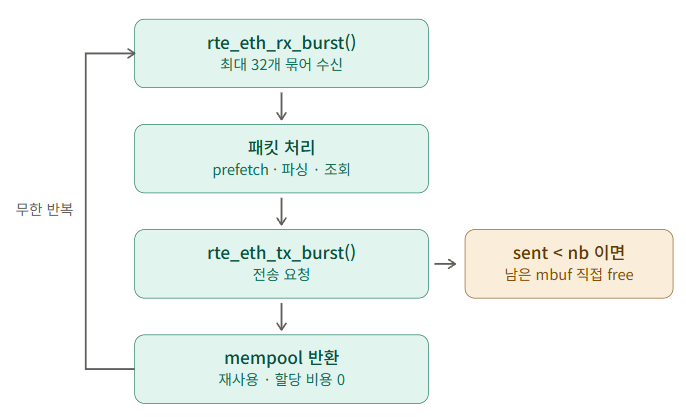
[그림 3] run-to-completion 루프 — 오른쪽 노란 갈래가 mbuf 누수 1위 원인입니다.
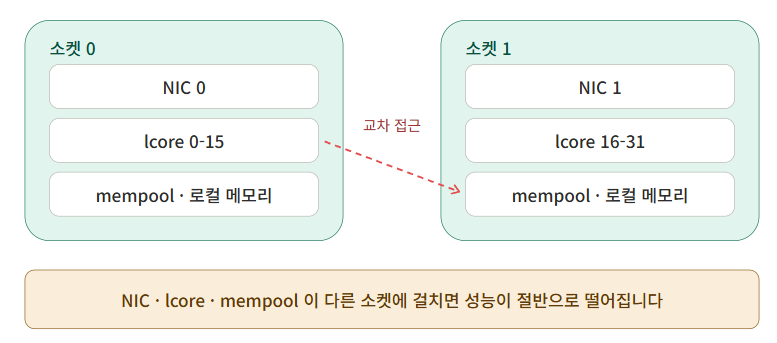
[그림 4] NUMA 배치 — 성능의 절반이 조용히 사라지는 지점입니다.
아래는 같은 내용을 한 장으로 묶은 것으로, 각 단계에서 실제로 호출되는 함수와 주의 지점까지 함께 표시했습니다.
| [ 커널 경로 vs DPDK 경로 ] <커널> NIC → IRQ → softirq → sk_buff 할당 → netfilter/라우팅 → 소켓큐 → 복사 → recv() 수천 사이클 / 패킷 <DPDK> NIC ──DMA──> hugepage 버퍼 ──포인터──> 유저 프로세스 루프 커널 개입 0 / 복사 0 ────────────────────────────────────────────────── [ 계층 구조 ] 애플리케이션 (l3fwd / OVS-DPDK / UPF / LB ...) └─ DPDK 라이브러리 (rte_ring / rte_hash / rte_lpm / rte_crypto ...) └─ EAL : hugepage 확보 · PCI 스캔 · lcore 고정 · 장치 초기화 └─ PMD : ixgbe / i40e / ice / mlx5 / ena / af_xdp ... └─ VFIO / IOMMU (커널이 허락한 유일한 통로 — DMA 주소 변환·보호) └─ NIC 하드웨어 (RSS · rte_flow 오프로드) [ 단계별 실행 — run-to-completion 모델 ] 0) 기동 : rte_eal_init() → hugepage mmap → 포트 configure → 큐 setup → 링크 up ※ 이 시점에 메모리와 코어를 전부 선점. 이후 동적 할당 없음 ⬇ 1) NIC가 RSS 해시로 흐름을 큐에 분배 (같은 5-tuple → 항상 같은 큐 → 순서 보존) ⬇ 2) DMA로 mbuf 데이터 영역에 직접 기록 → RX 디스크립터 링에 표시 ⬇ 3) lcore N 의 무한 루프 ── 여기가 성능의 심장 ── nb = rte_eth_rx_burst(port, queue_N, bufs, 32) ← 인터럽트 없이 즉시 반환 ├─ nb == 0 → 즉시 재시도 ★ CPU 100% 의 정체 └─ nb > 0 → 32개를 묶어서 처리 (prefetch → 파싱 → 조회 → 수정) ⬇ 4) sent = rte_eth_tx_burst(...) → sent < nb 면 남은 mbuf 는 직접 free 필수 ※ 이 한 줄을 빠뜨리는 것이 mbuf 누수 1위 원인 ⬇ 5) mbuf 는 mempool 로 반환 → 코어별 캐시에 들어가 재사용 (할당 비용 0) [ NUMA 배치 ★ ] NIC(PCIe) · lcore · mempool 셋이 같은 소켓에 있어야 함 socket0: [NIC0]─[core 0-15]─[mem0] socket1: [NIC1]─[core 16-31]─[mem1] 하나라도 교차하면 QPI/UPI 를 건너며 성능이 조용히 절반이 됩니다. [ 핵심 원칙 ★ ] DPDK 는 패킷을 빨리 옮기는 기술이 아니라, CPU 코어 전용화와 운영 가시성을 지불하고 지연·처리량을 사는 거래입니다. |
Ⅴ. DPDK 설치 방법
ⅰ. 순서를 지키는 것이 중요합니다. hugepage → IOMMU → 드라이버 바인딩 → 빌드 순인데, 이 중 앞의 둘은 부팅 파라미터라 재부팅이 필요합니다. 먼저 하드웨어 지형부터 확인합니다. NIC가 어느 NUMA 노드에 붙어 있는지 모르고 코어를 고르면 뒤에서 원인 불명의 성능 저하로 돌아옵니다.
| [root@feccle] # lscpu | grep -E "NUMA|Socket|Model name" # 소켓별 코어 범위 파악 [root@feccle] # lspci | grep -i ethernet # 대상 NIC 의 PCI 주소 확보 (예: 0000:81:00.0) [root@feccle] # cat /sys/bus/pci/devices/0000:81:00.0/numa_node # ★ 이 값이 코어 선택의 기준 [root@feccle] # dmesg | grep -i -e DMAR -e IOMMU | head # IOMMU 활성 여부 |
ⅱ. hugepage와 IOMMU는 부팅 시 잡습니다. 부팅 후 sysctl로 2MB 페이지를 할당할 수도 있지만, 가동 중인 서버는 메모리가 단편화되어 있어 요청한 만큼 안 잡히는 일이 흔합니다. 1GB 페이지는 아예 부팅 파라미터로만 확보됩니다. 운영 장비라면 처음부터 커널 커맨드라인에 박아 두십시오. isolcpus로 데이터플레인 코어를 스케줄러에서 빼 두는 것도 이 단계에서 함께 합니다.
| [root@feccle] # vi /etc/default/grub # GRUB_CMDLINE_LINUX 에 아래를 추가 default_hugepagesz=1G hugepagesz=1G hugepages=16 # 1GB × 16 intel_iommu=on iommu=pt # AMD 는 amd_iommu=on. ★ VFIO 의 전제 조건 isolcpus=2-15 nohz_full=2-15 rcu_nocbs=2-15 # ★ 데이터플레인 코어를 OS 에서 격리 [root@feccle] # grub2-mkconfig -o /boot/grub2/grub.cfg && reboot [root@feccle] # cat /proc/meminfo | grep -i huge # 재부팅 후 확인 [root@feccle] # cat /sys/devices/system/node/node*/hugepages/hugepages-1048576kB/nr_hugepages # ★ 합계가 아니라 NUMA 노드별로 잡혔는지를 보십시오. 한쪽에 몰리면 반대편 앱이 기동 실패합니다 |
ⅲ. 빌드와 드라이버 바인딩. DPDK는 meson/ninja로 빌드합니다. 바인딩은 되돌릴 수 있으니 겁낼 필요는 없지만, 관리용 NIC를 실수로 바인딩하면 SSH가 끊깁니다. 원격 작업이라면 콘솔 접근을 먼저 확보하고 시작하십시오. 실제로 가장 많이 발생하는 사고이고, 데이터센터 출동으로 이어집니다.
| [root@feccle] # dnf install -y meson ninja-build gcc numactl-devel python3-pyelftools libpcap-devel [root@feccle] # git clone --branch v25.11 --depth 1 https://github.com/DPDK/dpdk.git && cd dpdk # ★ LTS 태그를 명시. main 브랜치를 프로덕션에 쓰지 마십시오 [root@feccle] # meson setup build -Dplatform=native -Dbuildtype=release [root@feccle] # ninja -C build && ninja -C build install && ldconfig [root@feccle] # modprobe vfio-pci [root@feccle] # dpdk-devbind.py --status # ★ 반드시 먼저. 관리 NIC 가 어느 것인지 확인 [root@feccle] # ip link set ens1f0 down [root@feccle] # dpdk-devbind.py --bind=vfio-pci 0000:81:00.0 [root@feccle] # dpdk-devbind.py --bind=ixgbe 0000:81:00.0 # 되돌릴 때 # ※ NVIDIA(mlx5) 계열은 bifurcated 드라이버라 바인딩 전환이 불필요합니다 |
Ⅵ. DPDK 사용 방법
ⅰ. 자체 코드를 짜기 전에 testpmd로 기반을 검증하십시오. 직접 만든 앱이 느릴 때 "내 코드가 문제인가, 환경이 문제인가"를 가르는 기준선이 필요한데, testpmd가 그 기준선입니다. 여기서 라인레이트가 안 나오면 코드를 아무리 고쳐도 소용없습니다.
| [root@feccle] # dpdk-testpmd -l 2,3,4 -n 4 -a 0000:81:00.0 -- -i --rxq=2 --txq=2 --nb-cores=2 # -l : 사용할 lcore 목록 (첫 코어는 관리용, 나머지가 포워딩) # -n : 메모리 채널 수 / -a : 사용할 PCI 장치만 허용(allowlist) # ★ -l 의 코어는 반드시 NIC 와 같은 NUMA 노드에서 고르십시오 testpmd> show port info 0 # 링크 상태·속도·socket id 확인 testpmd> set fwd macswap # io / mac / macswap / rxonly / txonly testpmd> start testpmd> show port stats all # ★ imissed / ierrors / rx_nombuf 를 보십시오 testpmd> stop |
ⅱ. 애플리케이션 루프의 최소 형태. DPDK 코드는 길어 보여도 본질은 아래 열몇 줄입니다. 주석으로 표시한 세 지점이 실무에서 사고가 나는 자리입니다.
| /* 기동: 코어별 mempool 을 해당 NUMA 노드에 생성 */ pool = rte_pktmbuf_pool_create("MBUF_POOL", NUM_MBUFS, MBUF_CACHE_SIZE, 0, RTE_MBUF_DEFAULT_BUF_SIZE, rte_eth_dev_socket_id(port)); /* ★① rte_socket_id() 아님 — NIC 기준 */ /* 데이터플레인 루프 — 이 함수는 절대 반환하지 않습니다 */ for (;;) { uint16_t nb_rx = rte_eth_rx_burst(port, queue_id, bufs, BURST_SIZE); if (unlikely(nb_rx == 0)) continue; for (i = 0; i < nb_rx; i++) { rte_prefetch0(rte_pktmbuf_mtod(bufs[i], void *)); /* ★② 캐시 미스 은닉 */ process(bufs[i]); } uint16_t nb_tx = rte_eth_tx_burst(port ^ 1, queue_id, bufs, nb_rx); /* ★③ TX 링이 가득 차면 일부만 전송됩니다. 나머지를 반드시 직접 해제 */ if (unlikely(nb_tx < nb_rx)) while (nb_tx < nb_rx) rte_pktmbuf_free(bufs[nb_tx++]); } |
ⅲ. 운영 시 고려사항. DPDK 도입 실패는 대개 성능이 안 나와서가 아니라 운영이 감당되지 않아서 일어납니다.
| 항목 | 판단 기준과 권장 |
| 모니터링 공백 | tcpdump·ethtool·iptables·ss가 전부 무력화됩니다. 커널이 그 NIC를 모르기 때문입니다. dpdk-pdump와 애플리케이션 내부 카운터를 착수 시점에 함께 설계하십시오. 나중에 붙이려면 데이터플레인을 다시 건드려야 합니다 |
| CPU 지표의 무의미화 | 폴링이므로 사용률은 항상 100%입니다. 알람을 그대로 두면 매일 울리고, 오토스케일링 기준으로도 쓸 수 없습니다. Mpps·imissed·큐 점유율을 부하 지표로 대체하십시오 |
| 코어 예산 | 데이터플레인 코어는 다른 용도로 쓸 수 없습니다. 32코어 서버에서 14코어를 떼어 주면 나머지 워크로드는 18코어로 살아야 합니다. 이것을 서버 단가에 반영하지 않으면 산정이 틀립니다 |
| 하이퍼스레딩 | 형제 스레드는 실행 유닛을 공유합니다. 두 형제에 각각 PMD를 올리면 기대만큼 오르지 않고 지터만 커집니다. 물리 코어 단위로 배치하고, 형제는 비워 두거나 제어 플레인에 주십시오 |
| 컨테이너·K8s | hugepage 요청, SR-IOV Device Plugin, CPU Manager static 정책, 특권 또는 IPC_LOCK 권한이 모두 필요합니다. 일반 파드와 같은 방식으로 굴러가지 않습니다 |
| 무중단 업데이트 | 프로세스 재시작이 곧 포트 다운입니다. 커널 앱처럼 롤링 재시작으로 넘길 수 없습니다. 이중화를 링크 레벨(LACP·VRRP)이나 상위 트래픽 스티어링에서 설계해야 합니다 |
Ⅶ. DPDK 자주 쓰는 명령어
| 명령어 | 용도 / 실전 메모 |
| dpdk-devbind.py --status | 장치와 현재 드라이버 확인. 모든 작업의 0단계 |
| dpdk-devbind.py --bind=vfio-pci <PCI> | DPDK로 전환. 관리 NIC 확인 후 실행 |
| dpdk-hugepages.py -s | hugepage 현황 요약. NUMA 노드별로 봐야 의미 있음 |
| dpdk-testpmd -l ... -- -i | 대화형 성능 기준선 측정. 자체 앱 비교의 잣대 |
| show port stats all (testpmd) | imissed=NIC 드랍, rx_nombuf=mbuf 고갈. 원인 분기점 |
| show port xstats 0 (testpmd) | 벤더별 상세 카운터. 큐별 드랍 편중이 여기서 보임 |
| dpdk-pdump -- --pdump 'port=0,queue=*,rx-dev=/tmp/rx.pcap' | DPDK 세계의 tcpdump. 앱이 pdump 지원으로 빌드되어 있어야 함 |
| dpdk-proc-info -- --stats | 가동 중인 앱에 붙어 통계 조회. 재시작 없이 상태 확인 |
| lspci -vv -s <PCI> | grep -i numa | NIC의 NUMA 노드 확인. 성능 문제 1순위 점검 |
| --log-level=lib.eal:debug (EAL 인자) | 기동 실패 원인 추적. hugepage·IOMMU 에러가 여기 남음 |
사례. 성능 문제가 들어오면 저는 항상 같은 순서로 좁힙니다. ① show port stats에서 imissed가 오르는가 — 오르면 애플리케이션이 NIC 속도를 못 따라가는 것이고, 안 오르는데 느리면 병목은 NIC 바깥입니다. ② rx_nombuf가 오르는가 — 오르면 mbuf 고갈이므로 누수나 풀 크기 문제입니다. ③ 큐별 xstats에서 특정 큐에만 몰리는가 — 몰리면 RSS 분배 문제입니다. ④ 그다음에야 코드 프로파일링입니다. 이 순서를 건너뛰고 코드부터 들여다보다 며칠을 태우는 경우를 자주 봤는데, 위 세 카운터는 몇 초 만에 원인의 절반을 잘라 냅니다.
Ⅷ. DPDK 활용방안
ⅰ. 대안 기술 비교. 2026년의 현실은 "DPDK냐 커널이냐"의 양자택일이 아닙니다. 그 사이를 메우는 선택지가 여럿 생겼고, 대부분의 조직에는 중간 지점이 정답입니다.
| 기술 | 위치 | DPDK 대비 강점 | DPDK 대비 약점 |
| DPDK | 커널 완전 우회 | 최고 처리량·최저 지터. 오프로드·벤더 기능 접근이 가장 넓음 | 코어 전용화, 커널 도구 상실, 개발·운영 난도 최상 |
| XDP / eBPF | 커널 드라이버 진입점 | 커널 도구·네트워크 스택 유지, 무중단 로드, 검증기 기반 안전성 | 복잡한 상태 처리·사용자 라이브러리 활용에 제약. 최대 성능은 낮음 |
| AF_XDP | 커널 소켓 + 제로카피 | 드라이버 교체 불필요, 커널과 공존. DPDK PMD로도 붙일 수 있음 | 순수 DPDK 대비 처리량이 낮고 드라이버별 지원 편차 |
| SR-IOV 패스스루 | 하드웨어 분할 | VM별 NIC 직결. 하이퍼바이저 오버헤드 제거 | 유연성 상실(마이그레이션 제약), VF 수 한계. DPDK와 병용이 일반적 |
| VPP (fd.io) | DPDK 위의 스택 | L2~L4 기능이 이미 구현되어 있어 직접 짤 필요 없음 | 그래프 노드 모델 학습 비용. 프레임워크 방식에 맞춰야 함 |
| DPU / 스마트NIC | 카드 내 오프로드 | 호스트 CPU를 전혀 쓰지 않음. 격리도 우수 | 하드웨어 비용, 벤더 종속, 개발 생태계가 좁음 |
| 커널 + 튜닝 | 기존 스택 | 운영 도구·인력·문서가 전부 그대로. RSS·GRO·busy-poll로 상당 부분 개선 | 소패킷 라인레이트에는 도달 못 함 |
ⅱ. 잘 맞는 곳.
① 통신사 코어망 기능 — 5G UPF, vBNG, vRouter처럼 소패킷 라인레이트와 마이크로초 지연이 SLA인 영역.
② 가상 스위치 — OVS-DPDK로 호스트 내 VM 간 스위칭을 가속하는 NFV 표준 구성.
③ L4 로드밸런서·DDoS 완화 — 대량의 소패킷을 상태 최소로 넘기는 작업.
④ 금융 저지연 시스템 — 처리량보다 지터(꼬리 지연)가 핵심인 경우, 인터럽트를 없앤다는 점 자체가 가치입니다.
⑤ 고성능 트래픽 생성·분석기 — 상용 장비를 범용 서버로 대체하는 용도.
ⅲ. 언제 쓰면 안 되는가.
| 상황 | 이유 |
| 일반 웹·API 서버 | 병목이 패킷 처리가 아니라 애플리케이션 로직·DB입니다. 패킷당 예산이 이미 수만 사이클이라 커널 오버헤드는 오차 범위입니다 |
| 대용량 프레임 위주 트래픽 | 1500B·점보 프레임은 pps가 낮아 커널로도 충분합니다. DPDK의 이점은 소패킷에서만 극적입니다 |
| TCP 종단 처리가 필요한 경우 | DPDK에는 TCP 스택이 없습니다. 직접 구현은 현실적이지 않고, 외부 스택 도입은 또 하나의 큰 의존성입니다 |
| 운영 인력이 얇은 조직 | 평소 쓰던 진단 도구가 전부 사라집니다. 장애 시 원인 규명 가능한 인력이 최소 2명은 있어야 합니다 |
| 범용 클라우드 VM | hugepage·IOMMU·코어 고정을 제어할 수 없는 인스턴스가 많고, 되더라도 vCPU 스틸 타임이 지터를 만듭니다. 전용 인스턴스 타입인지 먼저 확인하십시오 |
| "일단 빠르게" 수준의 요구 | 목표 Mpps와 허용 지연이 숫자로 없다면 아직 DPDK를 검토할 단계가 아닙니다. 커널 튜닝과 AF_XDP를 먼저 소진하십시오 |
Ⅸ. DPDK 트러블 슈팅
ⅰ. "Cannot get hugepage information" 으로 기동조차 못 합니다: 첫 번째 벽이자 가장 흔한 벽입니다. 확인 순서는 ① /proc/meminfo에 HugePages_Free가 실제로 남아 있는가(전에 죽은 프로세스가 붙잡고 있을 수 있습니다), ② /dev/hugepages가 마운트되어 있는가, ③ 실행 권한이 충분한가입니다. 특히 비정상 종료한 DPDK 앱은 /dev/hugepages에 파일을 남기며, 이것이 다음 기동을 막습니다. 남은 파일을 지우면 즉시 해결되는데, 이걸 모르면 설정을 엉뚱하게 헤집게 됩니다. 부팅 후 sysctl로 2MB 페이지를 잡았다면 요청량과 실제 할당량이 다를 수 있으니 반드시 실측치를 확인하십시오.
ⅱ. 포트가 0개로 잡힙니다: 십중팔구 드라이버 바인딩 또는 IOMMU 문제입니다. dpdk-devbind.py --status로 대상 장치가 vfio-pci 아래에 있는지 보고, 커널 커맨드라인에 intel_iommu=on(AMD는 amd_iommu=on)이 들어갔는지 확인합니다. 여기서 IOMMU 없이 vfio-pci의 noiommu 모드로 우회하는 방법을 쓰고 싶은 유혹이 생기는데, 이는 프로세스에 물리 메모리 전체에 대한 DMA 권한을 주는 것과 같습니다. 개발 장비면 몰라도 운영계에서는 쓰지 마십시오. 한편 NVIDIA(mlx5) 카드는 bifurcated 드라이버라 바인딩 자체가 필요 없으니, 거기서 헤매고 있었다면 방향이 틀린 것입니다.
ⅲ. 성능이 기대치의 30~50%밖에 안 나옵니다: 코드보다 NUMA 배치를 먼저 의심하십시오. NIC·lcore·mempool 셋 중 하나라도 다른 소켓에 있으면 모든 패킷 접근이 소켓 간 인터커넥트를 건넙니다. 점검은 세 줄이면 끝납니다 — NIC의 numa_node, -l로 준 코어의 소켓, mempool 생성 시 넘긴 socket id. 특히 코드에서 rte_socket_id()(현재 실행 코어 기준)를 쓰고 rte_eth_dev_socket_id(port)(NIC 기준)를 안 쓰면, 겉보기엔 NUMA를 고려한 코드인데 실제로는 교차 배치가 됩니다. 조용히 절반을 잃는 전형적인 함정입니다.
ⅳ. 큐가 여러 개인데 한 큐에만 트래픽이 몰립니다: RSS 해시가 기대한 필드를 못 보고 있는 것입니다. 대표적으로 VXLAN·GRE 터널 트래픽은 외부 헤더의 IP 쌍이 몇 개뿐이라, 기본 RSS로는 전부 같은 큐로 갑니다. 내부 헤더 기반 분배를 지원하는 NIC라면 해당 오프로드를 켜고, 아니면 rte_flow로 규칙을 직접 기술해야 합니다. 이 증상은 전체 처리량 그래프만 보면 절대 안 보이고, 큐별 xstats를 봐야 드러납니다. 부하 테스트 트래픽이 몇 개 흐름으로만 구성되어 있어서 발생하는 착시도 흔하니, 테스트 트래픽의 흐름 다양성부터 확인하십시오.
ⅴ. imissed가 계속 증가합니다: NIC가 받았는데 애플리케이션이 못 가져간 패킷입니다. 즉 수신이 아니라 소비가 느린 것입니다. 순서대로 ① 처리 루프에 무거운 연산(로깅, 락, 동적 할당, 시스템 콜)이 들어가 있지 않은지, ② RX 디스크립터 수가 충분한지, ③ 버스트 크기가 지나치게 작지 않은지(32 미만이면 오버헤드가 상대적으로 커집니다), ④ 해당 코어가 다른 프로세스와 공유되고 있지 않은지를 봅니다. ④번은 isolcpus를 안 걸었을 때 자주 발생하며, 평상시엔 멀쩡하다가 백업이나 로그 로테이션이 도는 새벽에만 드랍이 튀는 형태로 나타나 원인 찾기가 유난히 어렵습니다.
ⅵ. CPU 사용률이 항상 100%라 부하를 알 수 없습니다: 고장이 아니라 설계입니다. 폴링 루프는 패킷이 없어도 계속 돕니다. 문제는 이 때문에 기존 모니터링·오토스케일링·용량 산정이 전부 무의미해진다는 것입니다. 대응은 두 가지입니다. 지표를 바꾸거나(초당 처리 패킷 수, 빈 폴링 비율, 큐 점유율을 앱이 직접 노출), 적응형 폴링을 넣는 것(빈 폴링이 연속되면 짧게 쉬거나 인터럽트 모드로 내려가기)입니다. 후자는 전력 효율에 도움이 되지만 깨어날 때 지연이 튀므로, 저지연이 목적이라면 넣지 않는 편이 맞습니다. 트레이드오프를 모르고 "CPU가 아까워서" 적응형을 켰다가 꼬리 지연이 나빠지는 경우를 봤습니다.
ⅶ. 수 시간 뒤 트래픽이 서서히 멎습니다 — mbuf 누수: 증상이 서서히 나타나 발견이 늦는 대표적 장애입니다. rx_nombuf 카운터와 rte_mempool_avail_count()가 단조 감소하면 확정입니다. 원인 1순위는 rte_eth_tx_burst()가 요청보다 적게 전송했을 때 남은 mbuf를 해제하지 않은 것입니다. TX 링이 가득 차는 상황은 정상 운영에서도 발생하므로, 이 분기는 예외가 아니라 정상 경로로 다뤄야 합니다. 그 밖에 드랍 처리 경로에서의 해제 누락, 패킷 복제 후 원본 미해제, 체인 mbuf의 일부만 해제하는 경우가 흔합니다. mempool 가용량을 상시 지표로 노출해 두면 몇 시간 전에 미리 알 수 있습니다.
ⅷ. 두 번째 DPDK 프로세스가 기동하지 못합니다: 여러 DPDK 앱이 한 호스트에 뜰 때는 --file-prefix를 서로 다르게 줘야 합니다. 기본값이 같아서 hugepage 설정 파일이 충돌하는 것이 원인입니다. 컨테이너로 돌릴 때도 동일하며, 여기에 더해 -a(allowlist)로 자신이 쓸 PCI 장치만 명시해야 합니다. 그러지 않으면 각 컨테이너가 호스트의 모든 DPDK 장치를 잡으려 들어 먼저 뜬 쪽이 이기는 경쟁 상태가 됩니다. 이 두 옵션은 단일 프로세스로 개발할 때는 필요 없다가 운영 배포 단계에서 갑자기 문제가 되는 전형입니다.
ⅸ. 패킷을 눈으로 보고 싶은데 tcpdump가 안 됩니다: 당연합니다. 커널은 그 NIC의 존재를 모릅니다. 대안은 dpdk-pdump인데, 애플리케이션이 pdump 지원으로 빌드·초기화되어 있어야만 붙습니다. 즉 장애가 난 뒤에 붙일 수 있는 도구가 아니라 처음부터 넣어 둬야 하는 도구입니다. 함께 권하는 것은 KNI 대체 경로나 rte_flow 미러링 규칙으로 샘플 트래픽만 커널 쪽으로 흘려보내는 탭을 설계 단계에서 마련해 두는 것입니다. "운영 중에 패킷을 못 본다"는 사실은 DPDK 도입 결정 회의에서 반드시 테이블에 올려야 하는 비용입니다.
ⅹ. DPDK를 올렸더니 애플리케이션이 안 빌드됩니다 — 버전 고착: DPDK는 LTS 계열 안에서만 ABI 호환을 보장합니다. 메이저 버전을 건너뛰면 API가 바뀌어 앱 수정이 필요하고, 이 때문에 실무에서는 특정 LTS에 몇 년씩 묶이는 일이 흔합니다. 그러면 보안 패치와 신규 NIC 지원을 못 받게 됩니다. 권장은 ① LTS 태그를 명시해 빌드하고(v25.11), ② pkg-config --modversion libdpdk를 CI에서 검증하고, ③ 다음 LTS 이행을 릴리스 계획에 미리 넣는 것입니다. 덧붙여 커널·드라이버 업그레이드 후에는 VFIO 동작이 달라질 수 있으므로, OS 업그레이드와 DPDK 검증을 항상 한 묶음으로 다루십시오. "커널만 올렸는데 데이터플레인이 안 뜬다"는 상황은 새벽에 겪기에 특히 괴롭습니다.
'네트워크' 카테고리의 다른 글
| 다차원 분류 축으로 이해하는 프록시(Proxy) (1) | 2026.08.28 |
|---|---|
| 대규모 데이터센터 네트워크의 핵심, VXLAN(Virtual Extensible LAN) (0) | 2026.08.05 |
| 차세대 무선 통신의 혁명, Wi-Fi 7(IEEE 802.11be) (0) | 2026.07.27 |
| 우리 집 인터넷이 '이중 NAT'인 이유: CGNAT와 NAT444 완벽 정리 (0) | 2026.02.24 |
| 무선 네트워크(Wireless Network)에 대해 알아보겠습니다. (0) | 2025.12.24 |