mydumper는 MySQL·MariaDB의 데이터를 여러 스레드로 나눠 동시에 덤프하는 논리 백업 도구입니다. 짝이 되는 myloader로 그 백업을 병렬로 복원합니다. MySQL에 기본 포함된 mysqldump가 한 번에 한 줄씩 순차로만 처리하는 것과 달리, mydumper는 테이블과 청크 단위로 작업을 쪼개 CPU와 디스크를 함께 활용합니다. 데이터가 수십 GB를 넘어가면서 mysqldump 백업이 몇 시간씩 걸리기 시작할 때 흔히 찾게 되는 도구입니다. 오픈소스로 GitHub에서 유지보수되며, 현재 0.16 이상 버전이 배포되고 있습니다.
Ⅰ. mydumper 란?
MySQL 백업은 크게 논리 백업과 물리 백업으로 나뉩니다. 논리 백업은 데이터를 INSERT 문이나 텍스트로 뽑아내는 방식이고, 물리 백업은 데이터 파일 자체를 복사하는 방식입니다. 앞서 다룬 Percona XtraBackup이 물리 백업 쪽이라면, mydumper와 mysqldump는 논리 백업 쪽입니다.
기존의 mysqldump는 단일 스레드로만 동작합니다. 코어가 여러 개이고 디스크가 빨라도 한 스레드가 순서대로 테이블을 훑기 때문에, 데이터가 커지면 백업 시간이 선형으로 늘어나고 그동안 락이 길게 잡히기도 합니다. 복원도 거대한 SQL 파일 하나를 한 줄씩 실행하므로 더 느립니다.
mydumper는 이 지점을 파고든 도구입니다. 여러 스레드가 테이블을 나눠 맡아 동시에 덤프하고, 결과를 테이블별·청크별 파일로 흩어 저장합니다. 덕분에 백업 시간이 코어 수에 따라 줄고, 복원 때도 여러 파일을 병렬로 적재할 수 있습니다. 쉽게 말해 "mysqldump를 여러 갈래로 나눠 동시에 돌리고, 그 결과를 다시 나눠 복원하는" 역할을 합니다.
Ⅱ. mydumper 주요 특징
ⅰ. 다중 스레드 병렬 처리: -t 옵션으로 지정한 스레드가 테이블·청크를 나눠 동시에 덤프합니다. 복원 도구 myloader도 같은 방식으로 병렬 적재합니다.
ⅱ. 파일 분리 저장: 하나의 큰 파일이 아니라, 스키마와 데이터를 테이블별 파일로 나눠 출력 디렉터리에 담습니다. 큰 테이블은 다시 여러 청크 파일로 쪼갤 수 있어 복원 병렬화에 유리합니다.
ⅲ. 일관된 스냅샷: 백업 시작 시 순간적으로 읽기 락을 걸어 기준 시점을 잡고, InnoDB 테이블은 일관된 스냅샷 트랜잭션으로 읽어 락을 곧바로 풀어 줍니다. 모든 스레드가 같은 시점의 데이터를 보게 됩니다.
ⅳ. 복제 위치 기록: 백업이 끝나면 metadata 파일에 그 시점의 바이너리 로그 위치와 GTID를 남깁니다. 이 값으로 백업 이후 복제(replication)를 붙일 수 있습니다.
ⅴ. 압축·필터: 덤프 파일을 바로 압축하고, 정규식이나 데이터베이스·테이블 목록으로 대상을 골라 뽑을 수 있습니다.
ⅵ. 청크 단위 분할: 행 수(-r)나 파일 크기(-F)로 큰 테이블을 여러 조각으로 나눠, 복원 시 여러 스레드가 한 테이블을 나눠 적재하도록 합니다.
Ⅲ. mydumper 동작 방식
1) 구성 요소
ⅰ. mydumper: 백업을 수행하는 본체입니다. 서버에 접속해 여러 스레드로 데이터를 뽑아 출력 디렉터리에 저장합니다.
ⅱ. myloader: mydumper가 만든 디렉터리를 입력받아 대상 서버에 병렬로 복원하는 도구입니다.
ⅲ. 출력 디렉터리: 테이블 스키마 파일(-schema.sql), 데이터 파일(테이블명.sql 또는 청크별 파일), 그리고 metadata 파일이 함께 담깁니다.
ⅳ. metadata 파일: 백업 시작·종료 시각과 바이너리 로그 위치·GTID를 기록한 텍스트 파일입니다. 복제 구성이나 시점 확인에 씁니다.
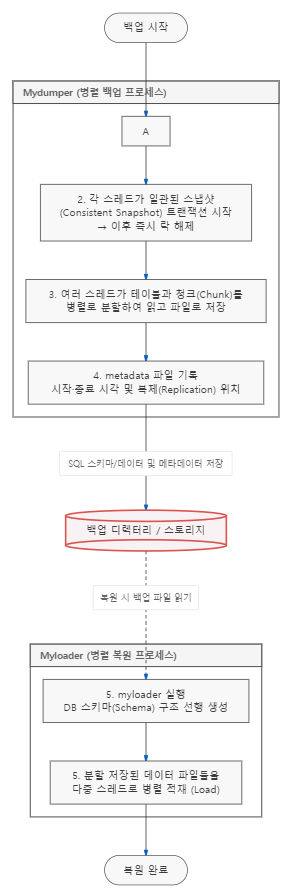
2) 데이터 흐름: mydumper는 먼저 짧게 전역 읽기 락을 걸어 일관된 기준 시점과 바이너리 로그 위치를 확보합니다. 이어 각 스레드가 일관된 스냅샷 트랜잭션을 열면 락은 곧바로 풀립니다. 그 뒤 스레드들이 맡은 테이블·청크를 동시에 읽어 파일로 내려쓰고, 끝나면 metadata에 위치를 남깁니다. 복원은 myloader가 스키마를 먼저 만들고 데이터 파일을 여러 스레드로 나눠 적재하는 순서로 진행됩니다.
Ⅳ. mydumper 구성 및 동작 흐름도
| 1) 순간 읽기 락으로 기준 시점 + binlog/GTID 위치 확보 ⬇ 2) 각 스레드가 일관된 스냅샷 트랜잭션 시작 → 락 해제 ⬇ 3) 스레드들이 테이블·청크를 병렬로 읽어 파일로 저장 ⬇ 4) metadata에 시작·종료 시각과 복제 위치 기록 ⬇ 5) (복원) myloader가 스키마 생성 후 데이터 파일을 병렬 적재 |
Ⅴ. mydumper 설치 방법
mydumper와 myloader는 한 패키지에 함께 들어 있습니다. 배포판 저장소에 있는 경우도 있고, 최신 버전은 GitHub 릴리스의 .deb/.rpm으로 받는 편이 확실합니다.
ⅰ. Ubuntu / Debian 계열 (universe 저장소에 패키지가 있습니다)
[root@feccle] # sudo apt update
[root@feccle] # sudo apt install mydumper
ⅱ. RHEL / Rocky / AlmaLinux 계열 (GitHub 릴리스의 rpm을 받아 설치)
[root@feccle] # sudo dnf install https://github.com/mydumper/mydumper/releases/download/v0.16.x-x/mydumper-0.16.x-x.el9.x86_64.rpm
  # 위 URL의 버전·배포판 부분은 실제 릴리스 페이지에서 확인해 맞춥니다.
ⅲ. 설치 후 버전을 확인합니다. mydumper와 myloader가 함께 설치됐는지 봅니다.
[root@feccle] # mydumper --version  # 설치된 버전 확인
[root@feccle] # myloader --version
Ⅵ. mydumper 기본 사용법 및 운영 시 주의점
1) 백업 예시. 특정 데이터베이스를 4개 스레드로, 100만 행 단위로 청크를 나눠 압축 백업합니다.
[root@feccle] # mydumper \
  -h 127.0.0.1 -u backup -p '****' \
  -B appdb \  # 대상 데이터베이스
  -t 4 \  # 스레드 수
  -r 1000000 \  # 100만 행 단위 청크 분할
  -c \  # 압축
  -o /backup/appdb-20260913  # 출력 디렉터리
2) 복원 예시. 백업 디렉터리를 대상 서버에 병렬 복원합니다. -o 는 같은 이름의 테이블이 있으면 덮어씁니다.
[root@feccle] # myloader \
  -h 127.0.0.1 -u restore -p '****' \
  -d /backup/appdb-20260913 \  # 입력 디렉터리
  -t 4 \  # 복원 스레드 수
  -o  # 기존 테이블 덮어쓰기
3) 운영 시 자주 겪는 문제와 조치
ⅰ. 백업 시작 때 서버가 잠깐 멈춤: mydumper는 기준 시점을 잡으려 순간적으로 전역 읽기 락(FLUSH TABLES WITH READ LOCK)을 겁니다. 평상시엔 짧지만, 오래 걸리는 트랜잭션이 열려 있으면 그것이 끝날 때까지 락이 대기하며 서비스가 멈춘 것처럼 보입니다. 운영 부하가 있는 원본 대신 복제본(replica)에서 백업하면 이 영향을 크게 줄일 수 있습니다.
ⅱ. MyISAM 등 비트랜잭션 테이블: InnoDB는 스냅샷 트랜잭션으로 락을 빨리 풀 수 있지만, MyISAM은 트랜잭션을 지원하지 않아 일관성을 위해 락을 더 오래 붙잡습니다. 가능하면 InnoDB로 통일하는 편이 백업 영향과 일관성 모두에 유리합니다.
ⅲ. 디스크 공간 부족: 논리 백업은 데이터를 텍스트로 풀어 쓰므로 용량이 큽니다. -c 로 압축하고, -F 로 파일 크기를 나눠 저장 공간과 전송을 관리합니다. 출력 디렉터리가 있는 볼륨의 여유 공간을 미리 확인합니다.
ⅳ. 스레드를 너무 높게 잡음: -t 를 코어 수보다 과하게 올리면 원본 서버의 부하와 디스크 IO가 오히려 병목이 됩니다. 코어 수와 디스크 성능에 맞춰 적당히(대개 4~8) 잡고, 원본이 서비스 중이면 더 보수적으로 둡니다.
ⅴ. 복원이 느리거나 실패: 복원은 대량 INSERT라 원본 백업보다 오래 걸립니다. 복원 전용 서버라면 innodb_flush_log_at_trx_commit 등 내구성 옵션을 잠시 완화하면 빨라집니다. 외래 키가 얽혀 순서 문제가 나면 복원 세션에서 외래 키 검사를 잠시 끕니다. myloader는 기본적으로 복원 내용을 바이너리 로그에 남기지 않으므로, 복원분을 복제로 흘려보내야 한다면 --enable-binlog 를 명시합니다.
ⅵ. 복제 붙일 위치를 놓침: 백업 이후 복제를 구성하려면 출력 디렉터리의 metadata 파일에 적힌 바이너리 로그 위치나 GTID를 사용합니다. 이 파일을 백업과 함께 보관하지 않으면 복제 시작 지점을 잃습니다.
Ⅶ. mydumper 자주 쓰는 옵션
| 옵션 | 설명 |
| -B, --database [DB] | 백업할 데이터베이스 지정 |
| -T, --tables-list [t1,t2] | 특정 테이블만 백업 |
| -t, --threads [N] | 병렬 스레드 수 |
| -r, --rows [N] | 테이블을 N행 단위 청크로 분할 |
| -F, --chunk-filesize [MB] | 데이터 파일을 지정 크기로 분할 |
| -c, --compress | 덤프 파일 압축 |
| -x, --regex [패턴] | 정규식으로 대상 DB·테이블 선별 |
| -o, --outputdir [경로] | 출력 디렉터리 지정 |
| myloader -d [경로] | 해당 백업 디렉터리를 복원 |
| myloader -o | 복원 시 기존 테이블 덮어쓰기 |
Ⅷ. mydumper 활용 방안
1) 주요 활용
ⅰ. 대용량 DB의 정기 백업. mysqldump로는 시간이 오래 걸리는 수십 GB급 데이터베이스를 병렬로 빠르게 덤프합니다.
ⅱ. 서버 이전·버전 업그레이드. 논리 백업이라 스토리지 엔진이나 버전이 달라도 복원되므로, 다른 서버로 옮기거나 메이저 업그레이드할 때 씁니다.
ⅲ. 복제본 신규 구축. metadata의 복제 위치를 이용해, 백업으로 초기 데이터를 채운 뒤 그 지점부터 복제를 붙입니다.
ⅳ. 부분 백업. 특정 데이터베이스나 테이블만 골라 뽑아, 개발·검증용 데이터셋을 만듭니다.
2) 대안 기술과의 비교
ⅰ. mysqldump: MySQL에 기본 포함되고 별도 설치가 필요 없습니다. 단일 스레드라 대용량에서 느리지만, 작은 DB나 간단한 이관에는 충분합니다. 규모가 커지고 시간이 문제가 되면 mydumper로 넘어갑니다.
ⅱ. Percona XtraBackup: 데이터 파일을 통째로 복사하는 물리 백업입니다. 초대형 DB를 통짜로 백업·복원할 때 논리 백업보다 훨씬 빠르지만, 같은 스토리지 엔진·버전 위주로만 복원되고 부분 추출이 어렵습니다. 이식성과 부분 백업이 중요하면 mydumper, 대용량 전체 백업 속도가 중요하면 XtraBackup이 맞습니다.
3) 언제 쓰지 않는 것이 좋은가
ⅰ. 데이터가 수백 GB~TB급으로 커서 논리 백업 시간·용량이 감당이 안 되면, 물리 백업(XtraBackup)이나 스토리지 스냅샷이 낫습니다.
ⅱ. 백업 대상이 작고 단순하면 mydumper의 병렬 구조가 이점이 없습니다. 기본 도구인 mysqldump로도 충분합니다.
정리하면 mydumper는 mysqldump로는 느려진 중·대용량 MySQL을 병렬로 빠르게 백업·복원하고, 다른 서버·버전으로 이식하거나 복제본을 구축할 때 적합합니다. 다만 초대형 데이터베이스의 전체 백업 속도가 우선이라면 물리 백업이 더 나을 수 있으니, 데이터 규모와 이식성 요구를 함께 보고 고르는 편이 좋습니다.
'데이터베이스' 카테고리의 다른 글
| 대규모 트래픽 처리를 위한 Redis Cluster 구조 및 활용 (0) | 2026.09.15 |
|---|---|
| DragonflyDB — 멀티스레드 인메모리 DB, Redis 25배 처리량 (0) | 2026.07.09 |
| Redis BSL락인·싱글스레드 끝낸 Valkey 8.1 멀티-IO (0) | 2026.06.11 |
| SQLite의 한계를 넘다: libSQL과 Turso가 여는 엣지 분산 데이터베이스의 미래 (0) | 2026.05.28 |
| DB 변경도 Git처럼: Bytebase로 구현하는 데이터베이스 CI/CD (0) | 2026.05.10 |